Hay una ficha de producto en árabe que dice قميص دنيم قطن 100% بقصة عادية: camisa
vaquera de algodón, corte regular. La frase renderiza con la fuente de sistema
árabe correcta, más pequeña que el latino de al lado por las mismas razones que
documenté en el artículo anterior de esta serie:
cada script ocupa una proporción distinta del em square, y sin corrección el
árabe cae siempre por debajo del tamaño visual del español. La respuesta que
prueba casi cualquiera antes de llegar a size-adjust es más simple todavía:
un selector [lang="ar"] con un font-size multiplicado. Es la que probé yo
primero, y la que descarté para el grueso del catálogo antes de implantar la
técnica del artículo anterior.
El multiplicador por [lang] es el primer sitio al que llega casi cualquiera
La razón por la que [lang] gana la carrera no es pereza, es que resuelve de
verdad un problema real con una línea de CSS:
[lang="ar"] { font-size: 1.4em; }No depende de local(), así que no hereda la fragilidad que documenté en el
artículo anterior: el nombre PostScript que resuelve en Chrome pero no en
Safari, la cara única que se lleva todo el unicode-range de un tirón. Y
sobrevive donde local() directamente no llega, que es Chrome en Android con
su restricción anti-fingerprinting sobre buena parte de las fuentes de
sistema. Cuando esa restricción bloquea la resolución de local('Geeza Pro'),
[lang(ar)] { font-size: 1.4em } sigue funcionando porque no necesita
localizar ninguna fuente: multiplica el tamaño de la que ya esté activa, sea
cual sea. Es la salida que dejé escrita como límite conocido en el artículo de
julio, y sigue siendo la primera herramienta que recomiendo a cualquiera que
llegue a este problema sin presupuesto de ingeniería para una familia de
@font-face por script.
El defecto no está en la herramienta, está en dónde opera. [lang] es un
selector de elemento: casa con el nodo que lleva el atributo, no con un rango
de caracteres dentro de él. Cuando ese nodo contiene solo texto árabe, la
distinción no importa y el multiplicador hace exactamente lo que promete. El
problema aparece en el caso más común de cualquier ficha de producto real: un
nodo de texto árabe con un fragmento latino incrustado, la talla, el precio,
el porcentaje de composición.
Lo que escala es el elemento entero, no el glifo
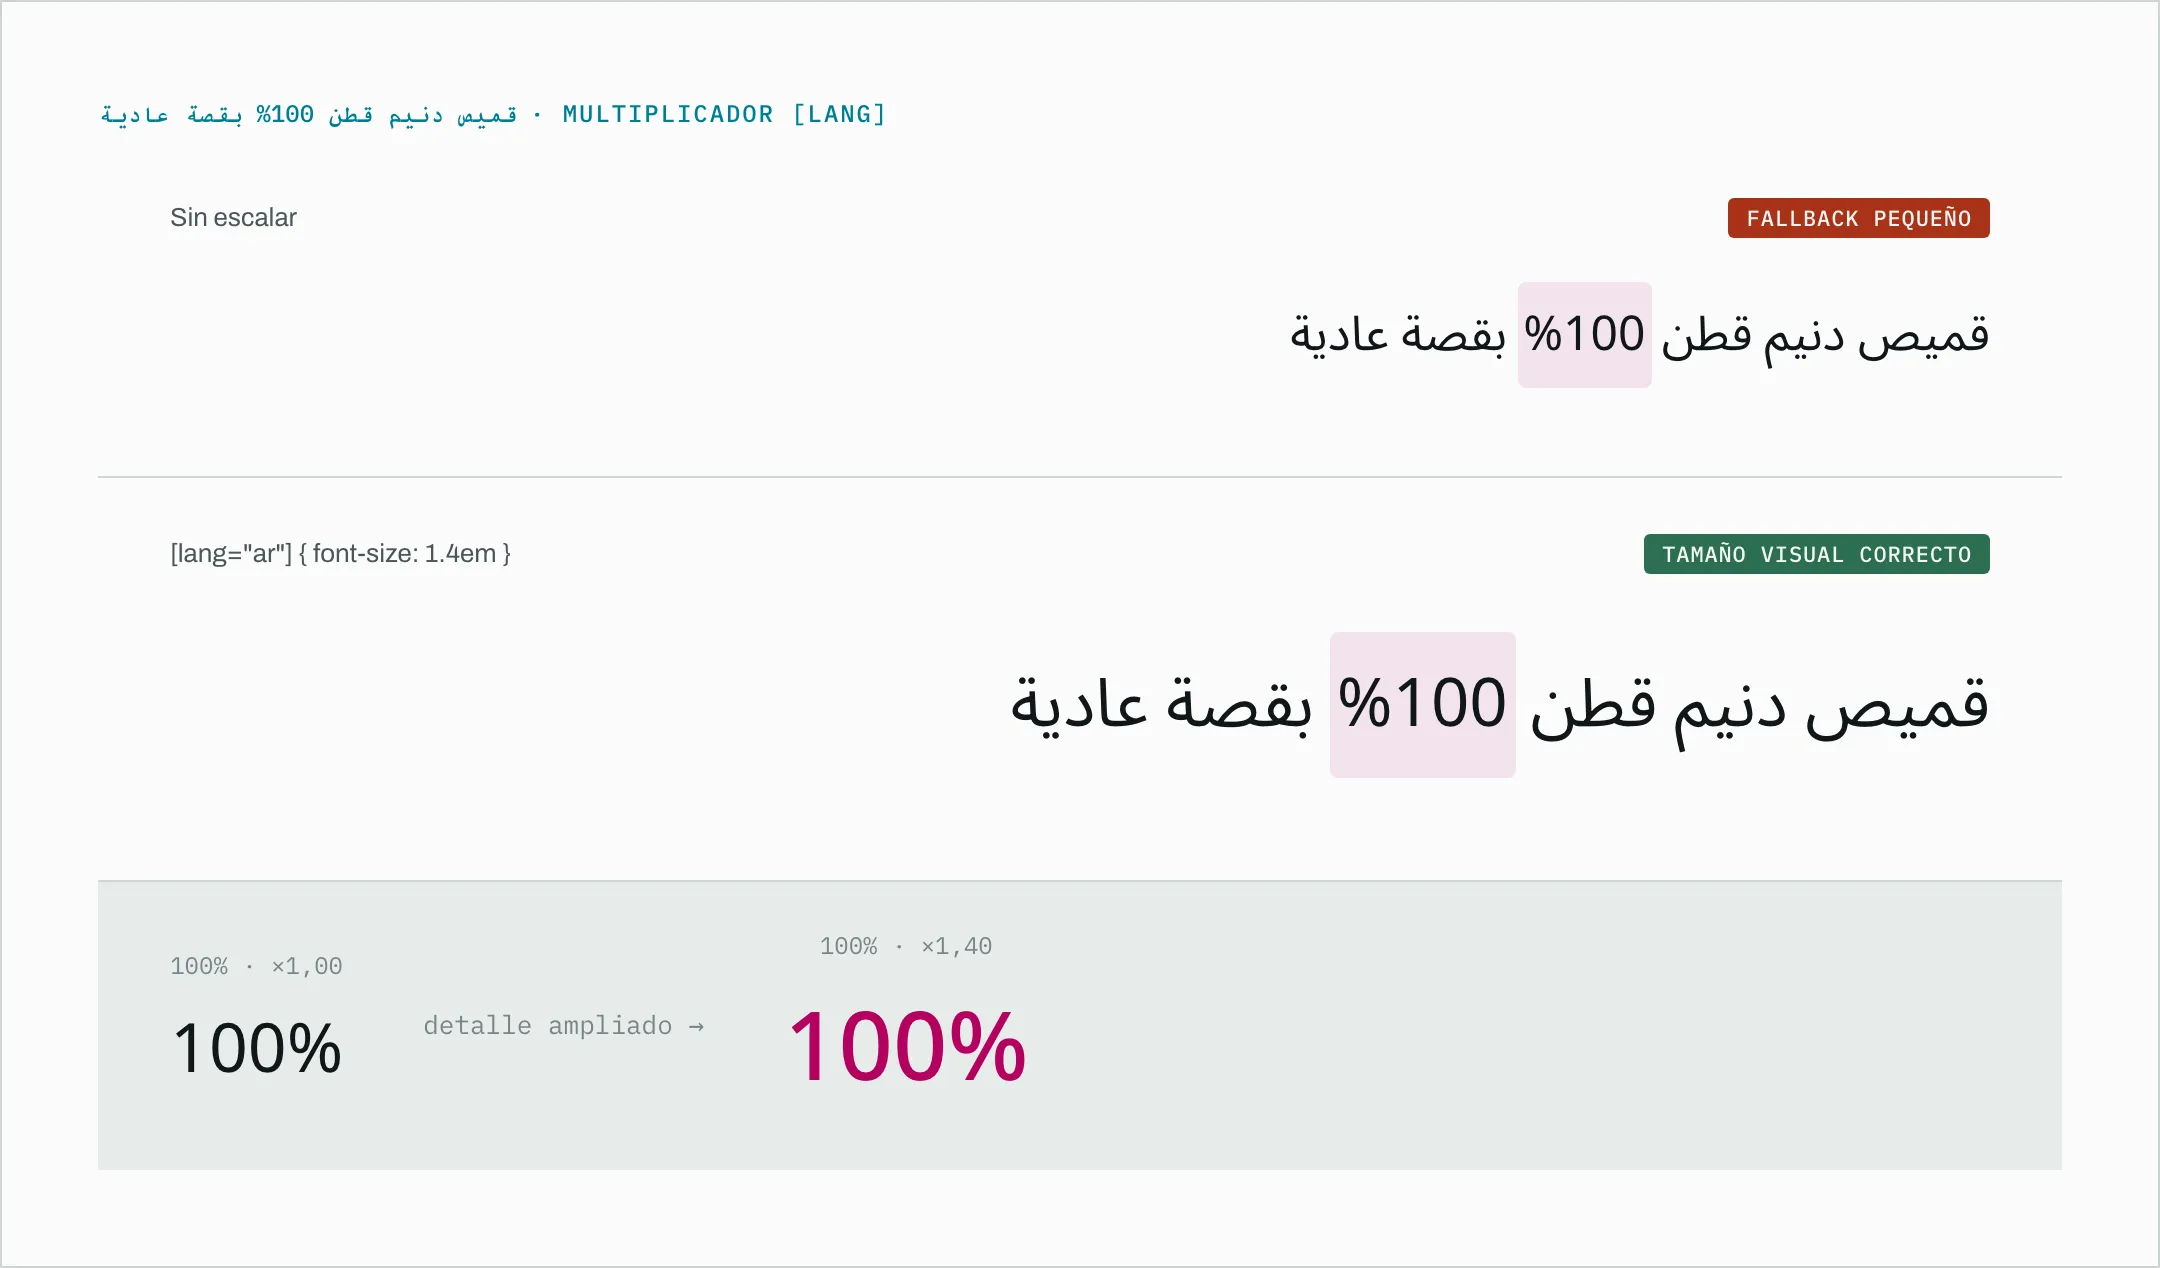
font-size no distingue scripts. Multiplica el tamaño de cada carácter dentro
del elemento con el mismo factor, sin mirar de qué alfabeto es. En
«قميص دنيم قطن 100% بقصة عادية» con [lang="ar"] { font-size: 1.4em }
aplicado al contenedor, el 100% crece exactamente igual que las letras
árabes que lo rodean: mismo 1,4, mismo tamaño final. En una interfaz que
compone la ficha con unicode-range y size-adjust por script, ese mismo
100% se queda en su tamaño de token porque cae fuera de los rangos no
latinos y la cara latina de marca no lleva ajuste. La diferencia entre las dos
técnicas se reduce a esa frontera: una escala el elemento completo, la otra
escala por carácter.
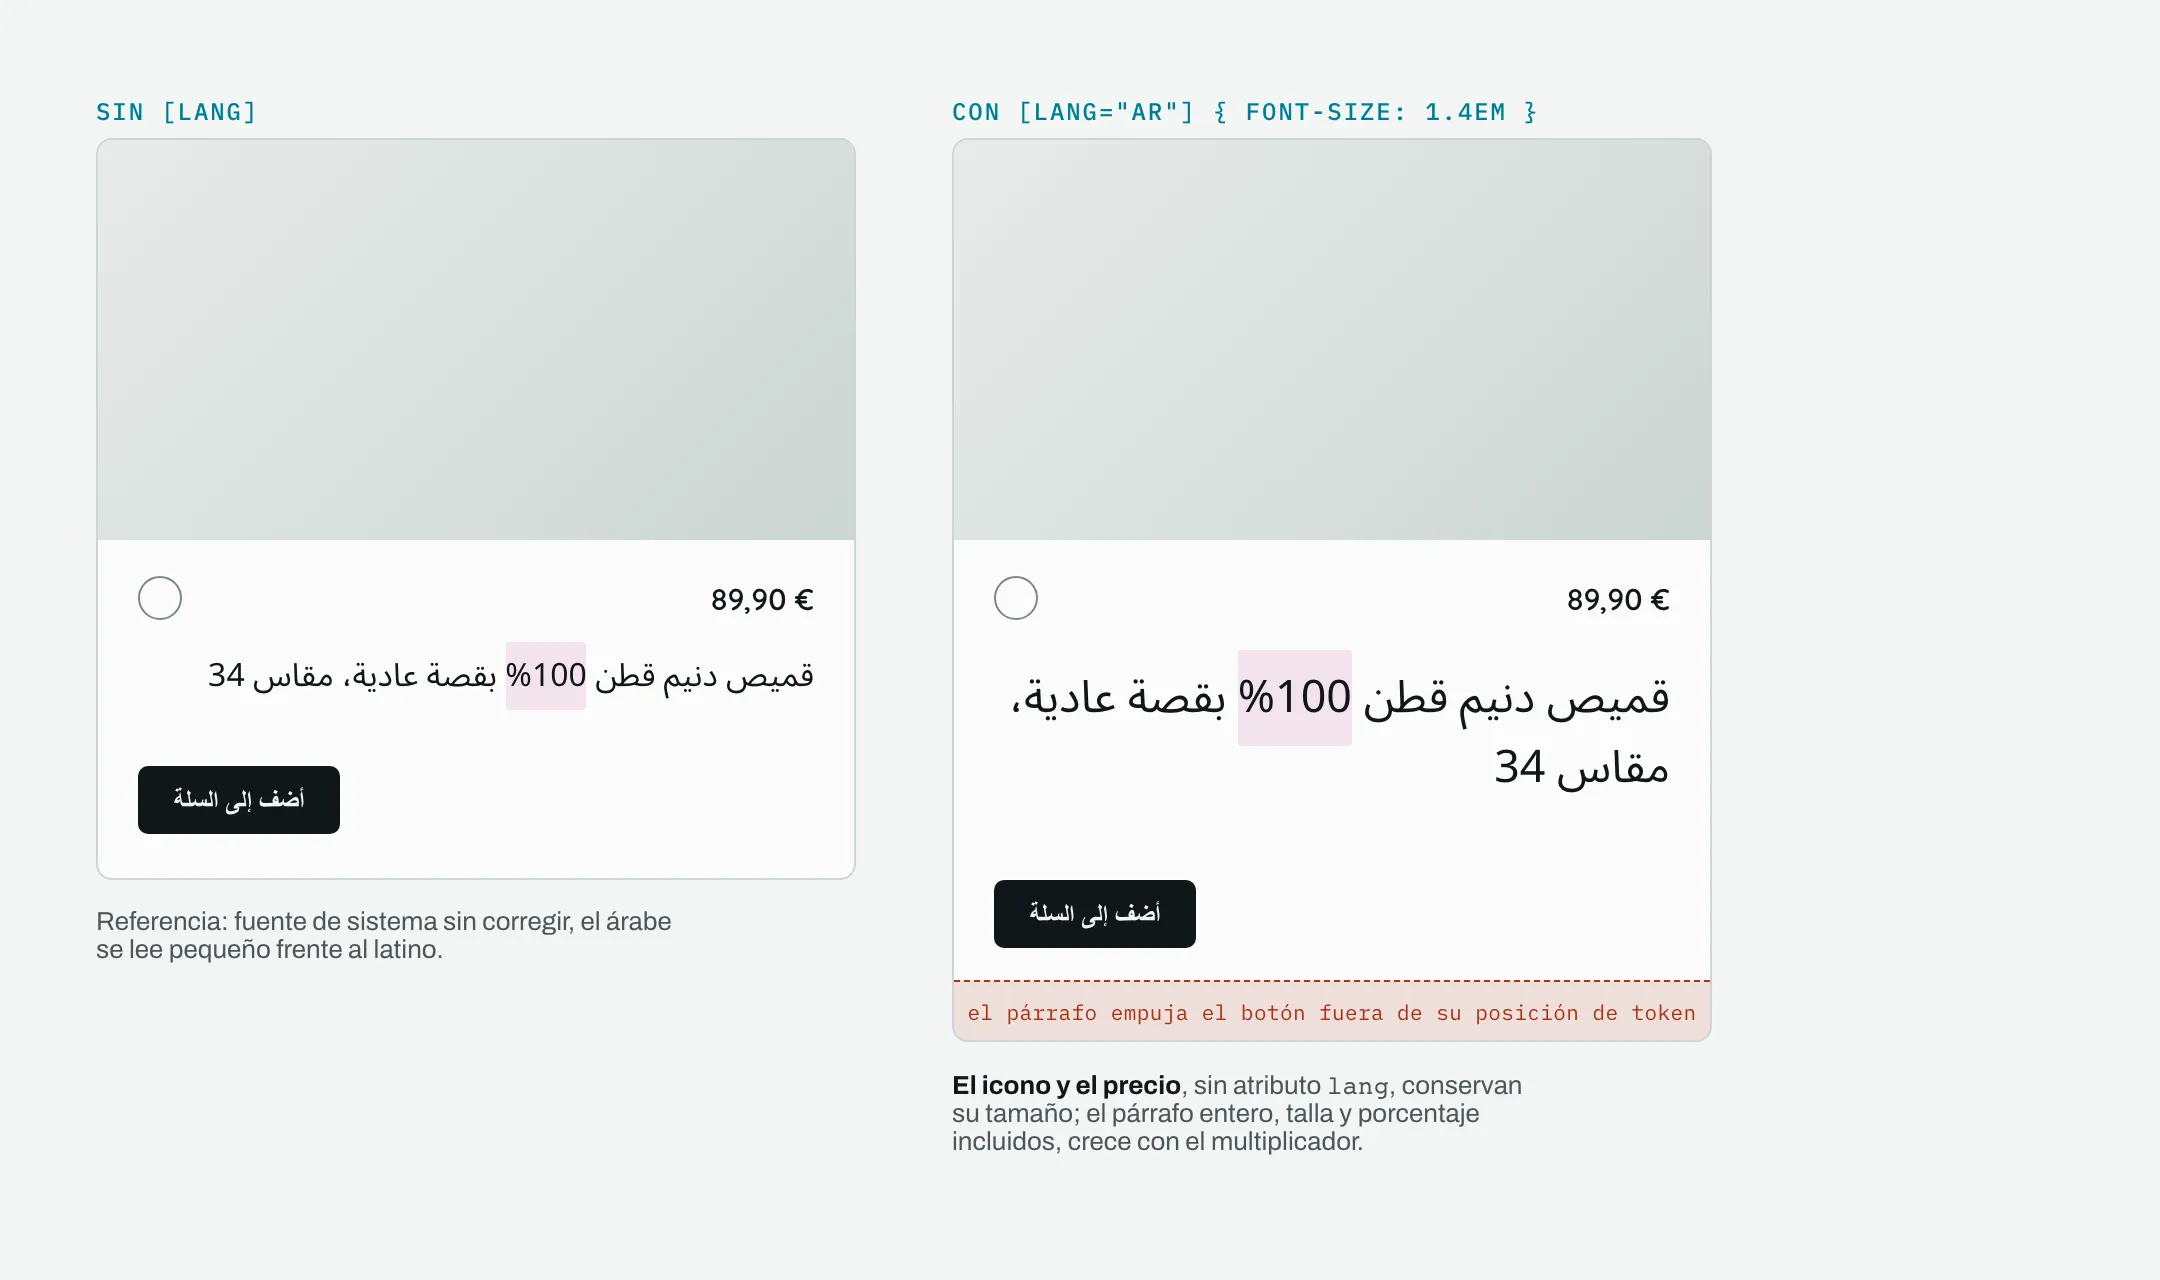
La consecuencia visual es la que aparece en cualquier ficha de producto que
mezcle idiomas en el mismo campo de texto, que es casi cualquier ficha de
producto de un catálogo internacional. Talla, precio, porcentaje de
composición y plazo de envío llegan casi siempre como fragmentos latinos
dentro de una frase en el idioma local, y con el multiplicador por [lang]
todos crecen a la vez que el texto que los envuelve.
El mismo mecanismo afecta a cualquier dato que llegue como fragmento latino
dentro del nodo, no solo al porcentaje: un código de color en formato
hexadecimal dentro de una descripción de variante, una fecha con separadores
latinos, una referencia de artículo alfanumérica. Todos comparten la misma
propiedad, font-size, con el texto que los envuelve, y todos crecen igual
que él. La talla de una prenda, «34», es fácil de detectar en pruebas porque
suele ir en un campo propio con su propio componente. El porcentaje de
composición casi nunca lo está: llega incrustado en la frase descriptiva que
compone el equipo de contenido, sin pasar por ningún campo estructurado, y por
eso es el primer sitio donde conviene mirar al dar por buena esta técnica.
El primer daño: el 100% crece con la frase que lo contiene
El desbordamiento de la tarjeta es el síntoma que se ve a simple vista. Hay un segundo daño que no se ve en una captura de pantalla estática porque no es de tamaño, es de orden, y solo aparece cuando el fragmento latino convive con texto árabe en el mismo nodo sin ningún marcado adicional.
El algoritmo bidireccional de Unicode decide la dirección de cada carácter con
un conjunto de reglas, y una de ellas, la regla W2, convierte los dígitos
europeos en dígitos árabes cuando les precede texto árabe fuerte en la misma
secuencia. El efecto práctico es que, en texto plano sin ningún aislamiento,
el signo % que debería quedar pegado al número que le precede deja de tener
esa regla de proximidad disponible y se resuelve como un carácter RTL
independiente. El resultado visual es un % que se despega del número y cae
a su izquierda, en vez de quedarse pegado a la cifra como en el texto de
origen. El proyecto Tipómetro, con el que trabajo esta calibración desde hace
meses, documenta seis casos de este comportamiento en BIDI_GROUPS, agrupados
en dos situaciones que aparecen con la misma frecuencia en cualquier
plantilla de producto:
| Caso | Resultado | Motivo |
|---|---|---|
| Fragmento latino en medio de la frase, texto plano | Se rompe | La regla W2 aísla el % del número y lo resuelve como RTL |
Mismo fragmento envuelto en <bdi> | Correcto | El aislamiento resuelve 100% como LTR con independencia del texto que lo rodea |
Mismo fragmento con aislantes Unicode FSI…PDI (U+2068…U+2069) | Correcto | Mismo efecto sin marcado HTML, útil cuando el texto llega como cadena plana desde un CMS |
Fragmento latino al principio, párrafo con dir="rtl" declarado | Correcto | El fragmento queda en el borde derecho, que es el inicio de línea en RTL |
Mismo fragmento con dir="auto" | Se rompe | Deduce la dirección del primer carácter fuerte; si es latino, todo el párrafo pasa a LTR |
Mismo fragmento sin atributo dir, heredado del documento | Se rompe | Hereda LTR del documento y falla igual que dir="auto", con cualquier orden de apertura |
Los tres primeros casos son el mismo fragmento, «100%», en tres marcados
distintos: el que rompe es el que llega sin ningún aislamiento, que es el
comportamiento por defecto de cualquier texto que un CMS entregue como cadena
plana sin pasar por un componente de composición. Los otros tres son la
variante donde el fragmento latino abre la frase, con nombres de corte o
líneas de producto; ahí el fallo no está en el fragmento, está en cómo se
declara la dirección del contenedor completo. dir="auto" falla porque
deduce la dirección del primer carácter fuerte de la cadena, y si ese carácter
es una letra latina, el párrafo entero se resuelve como LTR: el texto árabe
sigue siendo legible por dentro, pero se alinea desde la izquierda y el orden
entre fragmentos separados por texto neutro se invierte en cuanto hay más de
uno. El fallo solo se manifiesta en títulos que empiezan por texto latino, así
que atraviesa control de calidad sin que nadie lo note hasta que un idioma
concreto lo expone.
El segundo daño: el orden bidireccional se rompe con el mismo movimiento
Lo que conecta los dos daños no es el multiplicador de [lang], es la
ausencia de un límite explícito alrededor del fragmento latino. El
multiplicador de tamaño y la ausencia de aislamiento bidireccional son
defectos independientes que comparten la misma causa raíz: tratar el nodo de
texto como una unidad homogénea cuando en realidad contiene dos alfabetos con
reglas de composición distintas. Corregir el tamaño con size-adjust por
unicode-range, que es lo que documenté en el artículo anterior, no arregla
el bidi por sí solo: sigue haciendo falta envolver cada fragmento latino
incrustado en <bdi> o en aislantes Unicode si el contenido llega como cadena
plana desde el CMS. Son dos capas independientes, y confundirlas lleva a
pensar que arreglar el tamaño arregla el orden, cuando ninguna de las dos
técnicas de esta serie toca el algoritmo bidireccional.
Dónde [lang] sigue siendo la respuesta correcta
Descarté seguir extendiendo [lang="ar"] { font-size: 1.4em } a todo el árbol
de plantillas de ficha de producto y lo dejé como red de emergencia para el
escenario que documenté en el artículo de julio: cuando Chrome en Android
bloquea la resolución de local() sobre la fuente árabe del sistema y no hay
otra vía. La alternativa que consideré para el resto del catálogo fue envolver
a mano cada número, talla o código con un <span dir="ltr"> y un font-size
inverso, y la descarté por el coste operativo: cada plantilla de contenido
tendría que marcar explícitamente cada fragmento numérico, en un sistema de
gestión de contenido que no impone esa disciplina y que no la va a imponer
solo para este caso. El coste que asumo al dejar [lang] únicamente como red
de emergencia es que ese escenario concreto, Chrome en Android sin local(),
sigue mostrando el porcentaje sobredimensionado; es un coste que acepto porque
afecta a una fracción reducida del tráfico y porque la alternativa, marcar a
mano, no escala.
El límite de validez de la técnica es el que importa retener de este
artículo: [lang] con un multiplicador de tamaño funciona sin matices en
interfaces monolingües por mercado, donde ningún nodo de texto mezcla nunca
dos sistemas de escritura. Un formulario que se sirve completo en árabe a un
usuario árabe, sin datos latinos incrustados en la misma cadena, escala sin
ningún efecto colateral porque no hay frontera que cruzar dentro del nodo. En
cuanto el contenido mezcla scripts en el mismo campo de texto, que es el caso
habitual de cualquier catálogo de producto con datos numéricos, la técnica
necesita bajar de nivel de elemento a nivel de carácter. De ahí sale la
pregunta que resuelve la segunda parte de esta serie:
si se puede escalar el glifo sin tocar el elemento que lo contiene, y qué
parte de la caja de línea deja de escalar cuando se hace así.
La prueba que uso para dar por buena o por mala cualquier técnica de
tipografía multiscript antes de que llegue a producción es siempre la misma
frase de ficha de producto, no un saludo ni un pangrama: si la técnica supera
«قميص دنيم قطن 100% بقصة عادية» sin que el porcentaje se despegue del número
ni cambie de tamaño respecto al texto latino de referencia, supera la primera
criba. El multiplicador por [lang] la falla en el primer intento, y esa es
la razón por la que no llegó a generalizarse en el catálogo: no porque el
concepto fuera erróneo, sino porque la unidad sobre la que opera, el elemento
completo, es más gruesa que la unidad sobre la que hace falta operar, el
carácter.